
- Jakie ryzyka tworzy faceted navigation?
- Czym jest faceted navigation?
- Jak filtry tworzą wiele adresów dla tych samych produktów?
- Czym duplikacja różni się od kanibalizacji?
- Które kombinacje filtrów powinny być indeksowane?
- Jak ocenić potencjał landing page filtra?
- Czy każda fraza long tail potrzebuje osobnego URL-a?
- Jak zapobiec kanibalizacji kategorii i filtrów?
- Jak stosować canonical, noindex i robots.txt?
- Kiedy stosować rel canonical?
- Czy noindex i blokada robots.txt mogą działać razem?
- Czy robots.txt usuwa adres z wyników Google?
- Jak tworzyć indeksowalne landing pages filtrów?
- Jak powinien wyglądać stabilny URL filtra?
- Jak przygotować treść i linkowanie?
- Jak obsługiwać puste kombinacje i niedostępne produkty?
- Czy sortowanie, paginacja i infinite scroll powinny być indeksowane?
- Jak audytować faceted navigation i kontrolować crawl space?
- Jak wykryć crawl trap?
- Jak bezpiecznie wdrożyć zmianę?
- Jak monitorować kanibalizację po wdrożeniu?
- Najczęściej zadawane pytania
- Czy wszystkie filtry powinny mieć noindex?
- Czy canonical rozwiązuje każdą duplikację filtrów?
- Czy można połączyć noindex z blokadą w robots.txt?
- Czy filtrowanie AJAX jest bezpieczne dla SEO?
- Czy strony sortowania powinny być indeksowane?
- Jak wykryć kanibalizację filtrów?
- Co zrobić z filtrem bez produktów?
- Źródła i literatura
- Jakie źródła definiują zasady crawlowania filtrów?
- Gdzie sprawdzić aktualne zachowanie własnego sklepu?
- Przeczytaj również
Jakie ryzyka tworzy faceted navigation?
Filtrowanie produktów a SEO wymaga kontroli już przy projektowaniu kategorii: cztery filtry mające po pięć wartości mogą utworzyć 625 kombinacji. Googlebot może odwiedzać te adresy zamiast kluczowych kategorii, a Google Search Console pokaże później duplikację URL-i, soft 404 i strony wykluczone przez rel canonical (źródło: Google Search Central, 2025).
Największym zagrożeniem nie jest sam filtr, lecz brak reguł określających, które kombinacje mają istnieć jako strony wyszukiwania, a które pozostają wyłącznie funkcją zakupową. W audytowanych sklepach regularnie widzę, że kilka poprawnych filtrów połączonych bez ograniczeń tworzy setki tysięcy adresów bez popytu.
„Nawigacja fasetowa może tworzyć bardzo dużą, a w praktyce niemal nieograniczoną przestrzeń adresów URL wymagających pobierania.” – parafraza zaleceń Google Search Central, Managing crawling of faceted navigation URLs, 2025
Czym jest faceted navigation?
Faceted navigation to sposób zawężania listy produktów według wielu atrybutów, charakteryzujący się zmianą zestawu wyników, generowaniem stanów filtrów i często przypisywaniem im osobnych parametrów URL.
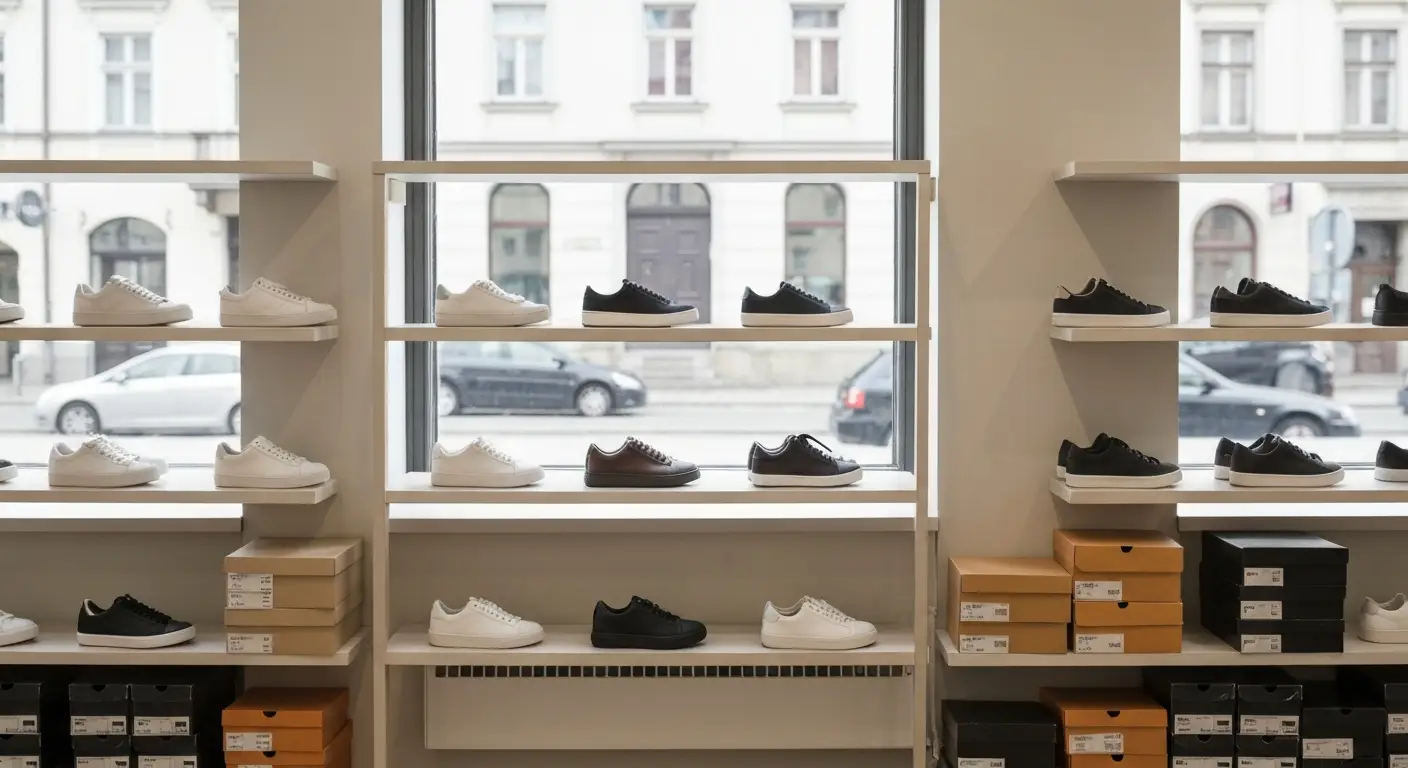
W kategorii obuwia fasetami mogą być marka, kolor, rozmiar, materiał i zakres ceny. Użytkownik potrzebuje ich do zakupów. Wyszukiwarka nie musi jednak indeksować każdego stanu interfejsu, zwłaszcza gdy dwa adresy pokazują ten sam ItemList i te same obiekty Product.
- Marka produktu – filtr Nike lub Adidas może odpowiadać osobnej intencji, jeśli sklep ma szeroki i trwały asortyment.
- Kolor produktu – wariant „czarne” może mieć popyt, ale połączenie pięciu kolorów zwykle nie tworzy użytecznej strony.
- Rozmiar obuwia – wartość 42 pomaga klientowi, lecz jej dostępność zmienia się szybciej niż oferta całej kategorii.
- Zakres ceny – parametry od 200 do 300 zł tworzą stan techniczny, którego granice często zależą od suwaka.
- Sortowanie wyników – kolejność od najtańszych nie zmienia podstawowej intencji ani zasadniczego zestawu produktów.
Jak filtry tworzą wiele adresów dla tych samych produktów?
Pierwszym źródłem duplikacji jest zapisywanie kolejności kliknięć, przez co marka i kolor mogą wystąpić w URL-u w dwóch równoważnych układach.
Adresy ?marka=nike&kolor=czarny oraz ?kolor=czarny&marka=nike powinny prowadzić do jednego znormalizowanego wariantu. Problem rośnie, gdy system dopisuje identyfikator sesji, widok siatki, liczbę produktów na stronie albo puste parametry.
- Kolejność parametrów – aplikacja powinna zawsze zapisywać filtry według ustalonego schematu, niezależnie od kolejności kliknięć.
- Wielkość liter – wartości „Nike” i „nike” muszą prowadzić do jednej wersji adresu.
- Kodowanie znaków – spacje, polskie litery i przecinki wymagają jednego sposobu kodowania.
- Parametry techniczne – widok listy, tracking i identyfikator sesji nie powinny tworzyć indeksowalnych wariantów.
- Filtry zerowe – kombinacja bez produktów nie może generować nieskończonej sieci pustych wyników.
Czym duplikacja różni się od kanibalizacji?
Duplikacja oznacza wiele URL-i z identyczną lub bardzo podobną treścią, natomiast kanibalizacja występuje, gdy różne strony konkurują o tę samą intencję i podobny zestaw zapytań.
Dwie kolejności parametrów pokazujące te same buty są duplikatem technicznym. Kategoria „buty do biegania”, filtr „obuwie sportowe + bieganie” i poradnik przygotowany jak oferta mogą natomiast walczyć o jedno zapytanie. Kanibalizacja nie oznacza automatycznej kary Google. Powoduje raczej rozproszenie sygnałów, niepewny wybór strony docelowej i rotację URL-i w wynikach.
- Duplikacja URL – równoważne adresy prezentują niemal ten sam zestaw produktów i kontekst.
- Kanibalizacja kategorii – dwa landing pages odpowiadają na tę samą potrzebę zakupową.
- Plagiat – skopiowanie cudzej treści jest innym zagadnieniem niż techniczne warianty filtrów.
- Paginacja – kolejne strony listy pokazują dalsze produkty, więc nie są z definicji identycznymi duplikatami.
- Rotacja w wynikach – zmieniający się URL dla jednego zapytania stanowi sygnał do analizy, a nie samodzielny dowód kanibalizacji.
Przy takim problemie zaczynam od sprawdzenia kanibalizacji słów kluczowych, a dopiero później zmieniam canonicale lub przekierowania. Techniczny skrót nie naprawi źle rozdzielonych intencji.
Które kombinacje filtrów powinny być indeksowane?
Indeksować należy kombinacje odpowiadające odrębnej intencji, mające potwierdzony popyt, stabilny asortyment oraz jeden preferowany URL. Landing page filtra powinien oferować własny kontekst i prowadzić do sensownego ItemList. Sortowanie, przypadkowe zakresy i wielokrotne kombinacje zwykle nie spełniają tych warunków (źródło: Google Search Central, 2025).
Nie istnieje uniwersalny limit dwóch lub trzech filtrów. Dla opon połączenie sezonu, szerokości, profilu i średnicy może dokładnie opisywać produkt. Dla sukienek zestaw koloru, rozmiaru, rękawa i chwilowej przeceny częściej tworzy niestabilną stronę bez trwałego popytu.
Jak ocenić potencjał landing page filtra?
Zacznij od potwierdzenia zapytań i intencji, a następnie sprawdź, czy kombinacja utrzymuje wystarczający wybór produktów przez większą część roku.
Z mojej praktyki wynika, że sam wolumen frazy nie wystarcza. Strona „czarne buty do biegania męskie” może mieć sens przy 40 modelach, ale ten sam filtr z trzema produktami i częstymi brakami magazynowymi będzie słabym wynikiem zakupowym.
- Popyt organiczny – zweryfikuj zapytania w Google Search Console, narzędziu słów kluczowych i wewnętrznej wyszukiwarce sklepu.
- Odrębna intencja – ustal, czy użytkownik oczekuje osobnej kolekcji, a nie tylko chwilowego uporządkowania produktów.
- Wielkość oferty – przyjmij próg właściwy dla kategorii, na przykład minimum 12 stabilnie dostępnych modeli.
- Trwałość asortymentu – sprawdź, czy strona nie stanie się pusta po jednej zmianie sezonu.
- Unikalny kontekst – przygotuj własny title, H1, opis i wskazówki zakupowe wynikające z danej cechy.
- Możliwość linkowania – upewnij się, że landing można naturalnie podłączyć z kategorii, poradnika lub innej kolekcji.
Czy każda fraza long tail potrzebuje osobnego URL-a?
Nie, osobny URL jest potrzebny tylko wtedy, gdy zapytanie opisuje trwałą intencję i da się dla niego utrzymać użyteczną ofertę.
Frazy różniące się szykiem, liczbą mnogą lub drobnym modyfikatorem mogą prowadzić do tej samej strony. Tworzenie landingów dla każdego wariantu słownego rozdrabnia treść. Lepsza bywa jedna mocna kategoria produktowa zoptymalizowana pod SEO, która naturalnie pokrywa kilka bliskich zapytań.
- Indeksuj – kombinację „laptopy gamingowe 17 cali”, jeśli ma popyt, stałą ofertę i osobną intencję.
- Nie indeksuj – sortowanie „od najdroższych”, ponieważ zmienia kolejność, a nie potrzebę użytkownika.
- Ogranicz linkowanie – wielokrotny wybór kolorów, gdy stan służy wyłącznie porównaniu oferty.
- Przekieruj – stary filtr marki do aktualnego landingu, jeśli zastąpiła go jedna jednoznaczna strona.
- Zwróć HTTP 404 – trwale błędną kombinację, która nie ma produktów ani trafnego odpowiednika.
Jak zapobiec kanibalizacji kategorii i filtrów?
Przypisz jednej intencji jedną preferowaną stronę, a pozostałe adresy podporządkuj jej przez treść, linkowanie, canonical lub przekierowanie zależnie od stopnia podobieństwa.
Tworzę prostą mapę: zapytanie, intencja, URL docelowy, typ strony i decyzja indeksacyjna. Jeśli kategoria „fotele biurowe” oraz filtr „krzesła + biuro” mają niemal identyczny asortyment, wybieram stronę lepiej dopasowaną do języka klientów. Potem porządkuję anchor teksty i sitemapę.
| Typ adresu | Przykład | Decyzja | Główny warunek |
|---|---|---|---|
| Landing filtra | Czarne baterie kuchenne | Indeksuj | Odrębny popyt i stabilna oferta |
| Sortowanie | Cena rosnąco | Nie indeksuj | Brak nowej intencji |
| Wielokrotny wybór | Czerwony lub zielony | Ogranicz | Stan użytkowy bez wartości w SERP |
| Pusty filtr | Marka bez produktów | HTTP 404 lub noindex | Trwałość braku oferty |
| Stary odpowiednik | Wycofana nazwa kolekcji | 301 | Istnienie trafnej strony zastępczej |
Jak stosować canonical, noindex i robots.txt?
Canonical wskazuje preferowaną wersję stron równoważnych, noindex prosi o wykluczenie URL-a z indeksu, a robots.txt kontroluje dostęp crawlera. Mechanizmy nie są zamienne. Googlebot musi pobrać stronę, aby odczytać noindex, dlatego wcześniejsza blokada w robots.txt może uniemożliwić oczekiwane usunięcie (źródło: Google Search Central, 2025).
Kiedy stosować rel canonical?
Stosuj rel canonical, gdy kilka dostępnych adresów prezentuje tę samą lub bardzo podobną treść, a jeden URL ma reprezentować cały zestaw.
Indeksowalny landing powinien zwykle mieć self-canonical. Wariant powstały przez zmianę kolejności parametrów może wskazywać wersję znormalizowaną. Nie kierowałbym natomiast każdego filtra do kategorii nadrzędnej, jeżeli pokazuje on odmienny zestaw produktów i odpowiada na inną potrzebę.
- Self-canonical – unikalny landing indeksowalny wskazuje własny stabilny adres.
- Canonical między duplikatami – równoważne kolejności parametrów wskazują jeden URL preferowany.
- Mapa XML – zawiera wyłącznie kanoniczne adresy przeznaczone do indeksowania.
- Linki wewnętrzne – prowadzą bezpośrednio do wersji kanonicznej, bez zbędnego łańcucha.
- Przekierowanie 301 – zastępuje canonical, gdy wariant nie musi pozostać dostępny użytkownikom.
Canonical jest wskazówką konsolidacji, a Google może wybrać inny reprezentatywny URL, jeśli sygnały w witrynie są sprzeczne (źródło: Google Search Central, 2025).
Czy noindex i blokada robots.txt mogą działać razem?
Nie w początkowym etapie usuwania, ponieważ blokada pobierania może uniemożliwić Googlebotowi zobaczenie meta robots noindex lub nagłówka X-Robots-Tag.
Najpierw pozwalam robotowi pobrać URL z noindex i monitoruję jego wykluczenie. Dopiero później oceniam, czy ograniczenie crawlowania ma sens. Nie wykonuję tej zmiany automatycznie dla całego sklepu, ponieważ linki, cache oraz wcześniejsze dyrektywy mogą wydłużyć proces.
- Etap pierwszy – usuń blokadę robots.txt z adresów, których dyrektywę noindex robot musi odczytać.
- Etap drugi – ustaw meta robots noindex lub X-Robots-Tag w poprawnej odpowiedzi HTTP.
- Etap trzeci – sprawdź wybrane URL-e w narzędziu inspekcji Google Search Console.
- Etap czwarty – monitoruj stan indeksacji i logi serwera przed kolejną zmianą.
- Etap piąty – ogranicz crawl tylko wtedy, gdy cel i skutki zostały potwierdzone.
„Aby dyrektywa noindex zadziałała, crawler musi mieć dostęp do strony; reguła robots.txt może zablokować jej odczyt.” – parafraza dokumentacji Google Search Central, Block Search indexing with noindex, 2025
Czy robots.txt usuwa adres z wyników Google?
Nie, robots.txt nie gwarantuje usunięcia URL-a z indeksu, ponieważ steruje pobieraniem zasobu, a nie samą decyzją o indeksowaniu.
Zablokowany adres może nadal zostać rozpoznany z linków zewnętrznych lub wewnętrznych. Jeżeli celem jest trwałe usunięcie nieistniejącej strony, właściwa bywa odpowiedź HTTP 404 lub 410. Jeśli strona istnieje, ale nie powinna trafiać do wyników, potrzebuje dostępnej dyrektywy noindex.
- robots.txt – ogranicza dostęp crawlera do wskazanych wzorców adresów.
- Meta robots noindex – przekazuje prośbę o niewłączanie strony do indeksu.
- X-Robots-Tag – dostarcza dyrektywę w nagłówku HTTP, także dla zasobów innych niż HTML.
- HTTP 404 – informuje, że żądany zasób nie istnieje.
- Rel canonical – wskazuje reprezentatywną wersję, lecz nie przekierowuje użytkownika.
Jak tworzyć indeksowalne landing pages filtrów?
Najpierw wybierz stabilny URL niezależny od kolejności kliknięć, a potem nadaj stronie własny title, H1, opis, listę produktów i linki HTML. Indeksowalny landing page filtra musi odpowiadać konkretnej intencji oraz zachować dostępność produktów, paginacji i danych Product lub ItemList bez polegania wyłącznie na interakcji JavaScript.
Jak powinien wyglądać stabilny URL filtra?
Ustal jeden format ścieżki lub parametrów i normalizuj wartości zanim aplikacja wygeneruje link dostępny dla Googlebota.
Adres /buty-do-biegania/czarne/ jest czytelny, jeśli stanowi prawdziwy landing. Parametr ?kolor=czarny także może działać, lecz system musi konsekwentnie używać jednej formy. UTM, kolejność sortowania i widok kafelków nie mogą zmieniać wersji preferowanej.
- Format adresu – jedna reguła obejmuje wielkość liter, ukośnik końcowy i kodowanie znaków.
- Nazwa cechy – parametr „kolor” nie występuje równolegle jako „color” lub „barwa”.
- Kolejność filtrów – system sortuje parametry według stałej listy, na przykład marka, typ, kolor, rozmiar.
- Wartości puste – aplikacja usuwa parametry bez wybranej wartości zamiast publikować pusty stan.
- Adres kanoniczny – serwer i HTML wskazują tę samą wersję preferowaną.
Jak przygotować treść i linkowanie?
Zacznij od odpowiedzi na potrzebę zakupową w title i H1, a następnie dodaj opis pomagający wybrać produkt z danego segmentu.
Programatyczny opis z podmienioną nazwą koloru zwykle powiela szablon. Obserwuję lepsze efekty, gdy redaktor wykorzystuje realne dane: liczbę modeli, zastosowanie, materiały, kompatybilność i różnice cenowe. Stronę wzmacniają linki z kategorii, poradników oraz powiązanych landingów.
- Title – łączy typ produktu, istotny filtr i nazwę sklepu bez kopiowania tytułu kategorii głównej.
- H1 – nazywa kolekcję językiem użytkownika, na przykład „Czarne buty do biegania męskie”.
- Opis kategorii – wyjaśnia zastosowanie i kryteria wyboru zamiast powtarzać listę produktów.
- Link kategorii – prowadzi do landingu przez naturalny anchor opisujący jego zakres.
- Dane uporządkowane – odzwierciedlają widoczną ofertę Product oraz ItemList, bez ukrytych elementów.
Przy większej przebudowie łączę tę pracę z audytem technicznym sklepu internetowego, analizą SEO kategorii produktowych oraz kontrolą wdrożenia danych produktowych.
Jak obsługiwać puste kombinacje i niedostępne produkty?
Trwale pusta kombinacja powinna zwracać HTTP 404 albo prowadzić do rzeczywiście równoważnej strony, natomiast chwilowy brak wymaga decyzji opartej na planowanej dostępności.
Nie przekierowuję automatycznie każdego pustego filtra do kategorii nadrzędnej. Taki wzorzec może wyglądać jak soft 404, ponieważ docelowa treść nie odpowiada żądaniu. Przy sezonowym braku pozostawiam landing tylko wtedy, gdy ma historię ruchu, jasną informację i realny termin powrotu oferty.
- Trwały brak kombinacji – zwróć HTTP 404, jeśli nie istnieje trafny zamiennik.
- Zmiana nazwy kolekcji – zastosuj 301 do jednoznacznego następcy zachowującego intencję.
- Czasowy brak produktów – utrzymaj stronę z informacją i alternatywami, jeśli oferta ma wrócić.
- Filtr bez popytu – usuń linki indeksacyjne i zastosuj zaplanowaną regułę noindex.
- Soft 404 – unikaj odpowiedzi 200 dla strony, która udaje wynik, ale nie przedstawia produktów ani pomocy.
Czy sortowanie, paginacja i infinite scroll powinny być indeksowane?
To zależy: sortowanie zwykle nie powinno być indeksowane, natomiast paginacja musi umożliwiać robotowi dotarcie do kolejnych produktów przez zwykłe linki HTML.
Infinite scroll może być przyjazny SEO, jeśli każda porcja treści ma osiągalny adres, serwer zwraca produkty bez konieczności symulowania przewijania, a kod zawiera linki do następnych stron. Pierwsza strona kategorii nie powinna canonicalizować całej paginacji, gdy kolejne URL-e prezentują odrębne produkty.
- Sortowanie cenowe – zwykle otrzymuje noindex lub pozostaje poza linkami dla crawlera.
- Paginacja – wykorzystuje crawlable linki z atrybutem href do kolejnych stron.
- Infinite scroll – stanowi warstwę interfejsu nad dostępną paginacją adresów.
- Canonical stron paginacji – wskazuje dany URL, jeśli każda część zawiera inny zestaw produktów.
- Produkty dalszych stron – pozostają osiągalne dla Googlebota bez kliknięcia i przewijania.
Jak audytować faceted navigation i kontrolować crawl space?
Audyt rozpocznij od zebrania wzorców parametrów, a następnie porównaj statusy HTTP, canonicale, dyrektywy robots, linki oraz dane Google Search Console z logami serwera. Test jednej kategorii powinien poprzedzać zmianę globalną. Dane i interfejs raportów należy sprawdzić ponownie przed wdrożeniem oraz monitorować co najmniej kwartalnie.
Jak wykryć crawl trap?
Porównaj liczbę realnych kombinacji zakupowych z liczbą adresów odkrywanych przez crawler i Googlebota; gwałtowna przewaga URL-i technicznych wskazuje potencjalny crawl trap.
Jeżeli sklep ma 20 kategorii i 200 wartości filtrów, a crawl znajduje kilka milionów wariantów, analizuję przede wszystkim parametry sortowania, kalendarze zakresów, wielokrotny wybór i powtarzalne ścieżki. Logi pokazują, czy bot wraca do nich częściej niż do nowych produktów.
- Crawl kontrolny – uruchom indeksowanie wariantów parametrów z zapisem statusów, canonicali i meta robots.
- Google Search Console – pogrupuj przykłady według wzorców URL oraz powodów wykluczenia.
- Logi serwera – policz wizyty Googlebota w filtrach, produktach, kategoriach i paginacji.
- Linkowanie wewnętrzne – znajdź elementy generujące nieskończone kombinacje dostępne przez href.
- Filtry zerowe – sprawdź, czy puste wyniki tworzą dalsze linki i odpowiadają kodem 200.
- Parametry techniczne – oddziel sortowanie, tracking i widok listy od filtrów opisujących ofertę.
W dużym katalogu zarządzanie budżetem crawlowania pomaga skoncentrować wizyty robota na nowych produktach, aktualizowanych kategoriach i landingach mających popyt.
Jak bezpiecznie wdrożyć zmianę?
Najpierw przetestuj reguły na jednej reprezentatywnej kategorii przez 2-4 tygodnie, zachowując listę zmienionych wzorców i gotowy plan wycofania.
W przypadkach, które prowadziłem, wdrożenie etapowe szybciej ujawnia błędne canonicale i utratę linków niż zmiana tysięcy adresów jednego dnia. Przed publikacją zapisuję bazową liczbę URL-i, kliknięcia, wyświetlenia, crawl oraz strony otrzymujące ruch.
- Zakres pilota – wybierz kategorię zawierającą typowe filtry, paginację i produkty sezonowe.
- Stan początkowy – zapisz ruch, liczbę indeksowanych URL-i, zapytania i częstotliwość crawlowania.
- Kontrola szablonu – przetestuj canonical, noindex, robots.txt, HTTP 404 oraz linki HTML.
- Plan rollbacku – przygotuj możliwość przywrócenia poprzednich reguł routingu i dyrektyw.
- Okno obserwacji – oceniaj zmianę po ponownym crawl, nie wyłącznie dzień po publikacji.
- Dokumentacja CMS – sprawdź aktualne zachowanie platformy przed wdrożeniem produkcyjnym.
Jak monitorować kanibalizację po wdrożeniu?
Śledź co tydzień zapytania przypisane do landingów i sprawdzaj, czy dla tej samej intencji nie rotują kategoria, filtr oraz strona poradnikowa.
Pojedyncza zmiana URL-a nie przesądza o problemie. Szukam powtarzalnego wzorca: spadku kliknięć strony preferowanej, naprzemiennego rankingu dwóch adresów i zbieżnego asortymentu. Następnie porównuję title, H1, linki, canonical oraz intencję wyników wyszukiwania.
- Ruch landingów – monitoruj kliknięcia i wyświetlenia osobno dla kategorii oraz filtrów.
- Rotacja URL-i – zaznacz zapytania obsługiwane naprzemiennie przez kilka stron.
- Liczba indeksowanych adresów – obserwuj wzrost niezwiązany z rozwojem asortymentu.
- Crawl filtrów – porównuj udział wizyt botów przed zmianą i po jej wdrożeniu.
- Stabilność oferty – wycofuj landing, który regularnie pozostaje pusty lub ma śladowy wybór.
Najczęściej zadawane pytania
Czy wszystkie filtry powinny mieć noindex?
Nie, filtry odpowiadające odrębnemu popytowi i posiadające stabilny asortyment mogą działać jako indeksowalne landing pages. Noindex stosuje się wobec kombinacji, które nie powinny konkurować w wynikach, po uwzględnieniu crawlowania i linkowania.
Czy canonical rozwiązuje każdą duplikację filtrów?
Nie, canonical jest sygnałem wyboru preferowanego URL-a, a nie bezwzględnym poleceniem. Musi pozostawać zgodny z treścią, mapą XML, linkami wewnętrznymi, przekierowaniami i faktycznym podobieństwem stron.
Czy można połączyć noindex z blokadą w robots.txt?
Nie należy zaczynać od takiego połączenia, ponieważ Googlebot może nie odczytać noindex na zablokowanej stronie. Najpierw trzeba umożliwić crawl dyrektywy, sprawdzić rezultat, a dopiero potem rozważyć ograniczenie dostępu.
Czy filtrowanie AJAX jest bezpieczne dla SEO?
Tak, jeśli ważne stany mają stabilne URL-e, produkty są dostępne w renderowanej treści, a paginacja wykorzystuje linki HTML. Sam AJAX nie przesądza o widoczności, lecz nie powinien być jedynym sposobem dotarcia do kolejnych produktów.
Czy strony sortowania powinny być indeksowane?
Nie w większości sklepów, ponieważ sortowanie zmienia kolejność, a nie zestaw produktów lub intencję. Wyjątek wymaga potwierdzonego popytu i realnie odmiennej wartości strony, nie tylko innego ułożenia tej samej listy.
Jak wykryć kanibalizację filtrów?
Porównaj w Google Search Console adresy wyświetlane dla tych samych zapytań, a potem oceń ich ofertę, intencję, title i linkowanie. Powtarzalna rotacja URL-i może wskazywać kanibalizację, ale wymaga ręcznej analizy wyników wyszukiwania.
Co zrobić z filtrem bez produktów?
Trwale pusta kombinacja powinna zwracać HTTP 404 albo zostać przekierowana do naprawdę równoważnego następcy. Przy czasowym braku można utrzymać landing, jeśli oferta wróci, strona ma historię ruchu i pokazuje użyteczne alternatywy.
Źródła i literatura
Dokumentację sprawdzono pod kątem zaleceń dostępnych w 2025 roku. Przed zmianą reguł w sklepie trzeba ponownie zweryfikować aktualne wytyczne Google Search Central oraz dokumentację używanego CMS.
Jakie źródła definiują zasady crawlowania filtrów?
Podstawę stanowią oficjalne materiały Google opisujące faceted navigation, konsolidację duplikatów i warunki odczytania noindex.
Gdzie sprawdzić aktualne zachowanie własnego sklepu?
Własne dane należy potwierdzić w Google Search Console, logach serwera, wynikach crawlera oraz dokumentacji platformy ecommerce.
- Google Search Central – Managing crawling of faceted navigation URLs, 2025.
- Google Search Central – How to specify a canonical URL with rel=canonical and other methods, 2025.
- Google Search Central – Block Search indexing with noindex, 2025.
- Google Search Central – Ecommerce pagination and incremental page loading, 2025.
- Google Search Console – raporty indeksowania, skuteczności i inspekcja URL, dostęp sprawdzany przed wdrożeniem.
Przeczytaj również
Potrzebujesz wsparcia przy naszej ofercie? Zobacz, jak pracujemy albo poproś o bezpłatną wycenę.
W SEO od 2016 roku. Zbudowałem i utrzymuję własną sieć ponad 150 serwisów tematycznych, na których zrealizowałem ponad 1000 publikacji — publikuję u siebie, nie pośredniczę. Prowadzę Agencję ITP i osobiście odpowiadam za strategię każdego projektu.